Blog — Data Vault & Data Warehouse Automation
Artikel zu Data Vault 2.0, Data Warehouse Automation, Snowflake, Databricks und praxisnaher Datentechnik.
-
Datensouveränität im KI-Zeitalter
Wie behalten Sie die Kontrolle über Ihre Daten, wenn KI-Modelle Zugriff auf alles brauchen? Dieses Webinar zeigt, wie Data Governance und moderne KI zusammenwirken.
Mehr lesen → -
Data Vault & Databricks Medallion-Architektur
Data Vault und Lakehouse gelten oft als unvereinbar. Dieses Webinar zeigt, warum Data Vault 2.0 und Databricks Medallion Architecture eine Stärke sind.
Mehr lesen → -
Wie ich über Business Value in Data denke
Datenprojekte scheitern selten an der Technologie. Sie scheitern, weil der Nutzen zu spät, in der falschen Form oder zu hohem Aufwand entsteht.
Mehr lesen → -
ISO 27001:2022 Zertifizierung & SOC 2 Type 2
Datavault Builder hat die ISO 27001:2022-Zertifizierung und SOC 2 Type 2-Konformität erreicht – ein Bekenntnis zu höchster Datensicherheit.
Mehr lesen → -
Flow.BI: KI-Datenmodelle importieren
Praxisdemo: Metadaten aus Flow.BI per Migration Vault in Datavault Builder migrieren – Hubs, Links, ETL-Pipelines und Deployment Schritt für Schritt.
Mehr lesen → -
Integration und Vereinheitlichung von Daten
Integration oder Unioning in Data Vault? Dieser Artikel erklärt den entscheidenden Unterschied und zeigt, wie Sie große Datenmengen optimal verarbeiten.
Mehr lesen → -
Near-Real-Time-Analytics mit Datavault Builder
Wie verarbeitet man Echtzeit-Datenströme aus IoT, Kreditkarten und Netzwerken effektiv? Webinar mit Datavault Builder und Kafka – auf Deutsch.
Mehr lesen → -
SSO mit Snowpark Container Services
Datavault Builder auf Snowflakes Snowpark Container Services ermöglicht Data Teams, Datenlösungen eigenständig einzurichten und zu betreiben – ohne IT-Abhängigkeit.
Mehr lesen → -
Bi-temporale Datenverarbeitung im DWH
Webinar für Banking, Versicherung und Finanzdienstleister: Wie Sie mit Datavault Builder bi-temporale Daten modellieren, laden und korrekt abfragen.
Mehr lesen → -
DVB auf Snowflake Snowpark Container Services
In diesem Video zeigen wir, wie einfach es ist, Datavault Builder auf den Snowflake Container Services zu betreiben.
Mehr lesen → -
GIT Check-In und Check-Out für Datenmodelle
Datavault Builder 7.1 bringt GIT Check-In und Check-Out für agile, verteilte Entwicklung – einfacher denn je.
Mehr lesen → -
Das Migration-Vault-Konzept
Ein Migration Vault ist ein spezialisierter Metadaten-Store, der selbst als Data Vault aufgebaut ist und die Migration von DBT zu Datavault Builder ermöglicht.
Mehr lesen → -
Talend Open Studio Alternative im Vergleich
Datavault Builder bietet ein breites Spektrum an Funktionen und Modulen – für denselben Preis wie früher kostenlose ETL-Tools.
Mehr lesen → -
Unified Star Schema automatisieren
Wie Datavault Builder die Implementierung des Unified Star Schema von Francesco Puppini und Bill Inmon vollständig automatisiert — schnell, präzise und wartungsarm.
Mehr lesen → -
Yale University: Datenmanagement revolutionieren — 75 % Kostenersparnis und schnellere Erkenntnisse
Datenmanagement-Automatisierung steigert die Produktivität deutlich: Wie die Yale University mit Datavault Builder 75 % der abgerechneten Stunden einsparte, ihr Datenteam erweiterte und schneller zu Erkenntnissen kam.
Mehr lesen → -
BI-SPEKTRUM Case Study: C&A auf Snowflake
BI-SPEKTRUM berichtete in Ausgabe 2023/3, wie einer unserer Kunden Datavault Builder zur Integration von SAP-Daten auf Snowflake einsetzt.
Mehr lesen → -
DDVUG Willibald Use Case Demo
Sieh, wie ein vollständiges Data Warehouse mit 2 Datenquellen in unter 3 Stunden in Datavault Builder aufgebaut wird — live beim DDVUG Willibald Use Case.
Mehr lesen → -
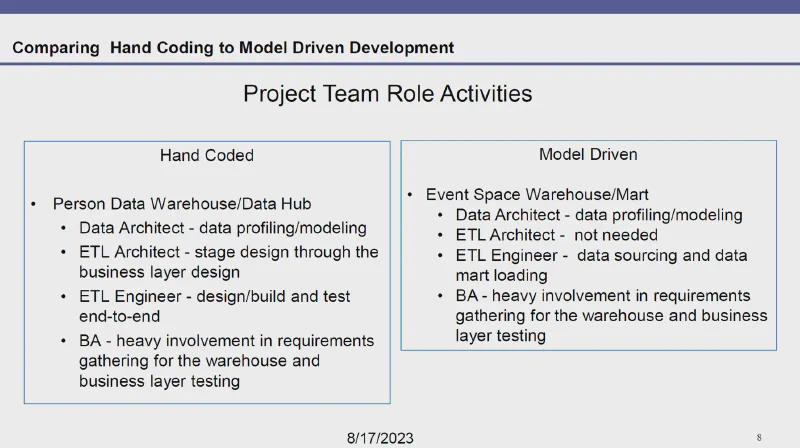
Ist Data Modeling tot?
Brauchen wir noch Datenmodelle? Welchen Wert haben Modelle, warum haben sie früher versagt – und wie schaffen wir damit echten Nutzen?
Mehr lesen → -
Data Vault bi-temporal: Inscription Time
Wann ist Inscription Time im Data Vault relevant? Drei Lösungsansätze — von Persistent Staging bis bi-temporalen Satelliten — mit Praxisbeispielen aus dem Banking.
Mehr lesen → -
Data Vault vs. Data Mesh — ein Widerspruch?
Schließen sich Data Vault und Data Mesh aus? Petr Beles erklärt, warum die Kombination aus Data Mesh, Data Vault und Automatisierung die richtige Antwort ist.
Mehr lesen → -
CI/CD mit Datavault Builder auf Snowflake
Wie Snowflakes Zero Copy Cloning zusammen mit Datavault Builder eine CI/CD-Pipeline für Ihr Data Warehouse ermöglicht — in wenigen Minuten einsatzbereit.
Mehr lesen → -
Sind Equi-Joins immer besser?
Sind INNER JOINs wirklich immer besser als LEFT JOINs? Ein reproduzierbarer Test auf Snowflake zeigt: die Antwort ist differenzierter.
Mehr lesen → -
3NF und Data Vault: Kein Grund zur Sorge
Unterstützt Datavault Builder 3NF? Die Antwort ist ja – und hier erfahren Sie, wie das funktioniert und warum Data Vault trotzdem die bessere Wahl ist.
Mehr lesen → -
DWH-Temporalität Teil 4: SCD-Type-2
Wie erstellt man SCD-Type-2-Dimensionen im Kimball-Stil aus einem Data Vault? Praxisleitfaden zu PIT-Tabellen, Joins und dem Einsatz von Datavault Builder.
Mehr lesen → -
DWH-Temporalität Teil 3: Zeitachsen ausgeben
In manchen Fällen ist die Ausgabe von Zeitachsen in Reports unerlässlich – etwa für Kundenhistorien, Betrugserkennung oder den Vergleich von Wissensständen.
Mehr lesen → -
DWH-Temporalität Teil 2: Komplexität
Wie sich temporale Komplexität im Data Vault reduzieren lässt – Datavault Builder-Nutzer fragen häufig, wie Änderungen über die Zeit korrekt abgebildet werden.
Mehr lesen → -
DWH-Temporalität Teil 1: Die Herausforderung
In den letzten Jahren wurde ich immer wieder mit der Anforderung konfrontiert, Reports mit SCD Type 2-Dimensionen zu erstellen – hier ist meine Orientierungshilfe.
Mehr lesen → -
Multi-Active Satellites im Data Vault
Petr Beles über die Implementierung von Multi-Active Satellites als Document Satellites im Data Vault: Muster, Abwägungen und praktische Empfehlungen.
Mehr lesen → -
Über Links im Data Vault
Petr Beles über Data-Vault-Links für Transaktionen: Muster, Stolperfallen und Designentscheidungen bei der Modellierung von Transaktions-Links.
Mehr lesen → -
Qlik
Zeigen Ihre Qlik-Apps und Power-BI-Reports unterschiedliche Zahlen?
Weder Qlik noch Power BI liegt falsch. Jedes Tool hat seine eigene Ladelogik, seine eigenen Definitionen und seine eigene Lineage, also wird dieselbe Kennzahl zweimal berechnet und niemand kann sie abgleichen. Die Regeln gehören in ein zentral verwaltetes Warehouse-Modell, das beide Tools lesen.
Mehr lesen → -
Tableau
Gibt es auf Ihrem Tableau-Server zu viele Versionen derselben Zahl?
Jede veröffentlichte .tdsx-Datei war an dem Tag, an dem sie entstand, vernünftig. Zusammen sind sie hunderte private Definitionen derselben Kennzahl, und niemand kann sagen, welche stimmt.
Mehr lesen → -
Power BI
Zeigen Ihre Power-BI-Reports unterschiedliche Zahlen für denselben Sachverhalt?
Finance, Sales und Operations haben jeweils ihr eigenes semantisches Modell gebaut, und jedes ist in sich stimmig. Die Definitionen waren nirgends falsch. Sie wurden nirgends abgestimmt.
Mehr lesen → -
Qlik
Bereinigen Sie dieselben Daten in jedem Qlik-Ladeskript erneut?
Dieselben Mapping-Loads, String-Korrekturen und Deduplizierungen werden in jeder App und jeder QVD-Schicht neu geschrieben, und die Kopien laufen auseinander. Die Bereinigung wiederholt sich pro Skript, weil keine integrierte Warehouse-Schicht sie einmal erledigt.
Mehr lesen → -
Qlik
Sind Ihre Qlik-Set-Analysis-Ausdrücke zu lang und zu langsam?
Set Analysis ist präzise für echte Vergleiche. Die meisten langen Ausdrücke in Ihrer App stehen dort, weil das Modell nie Historie, Flags oder eine einheitliche Granularität geliefert hat, und das Diagramm baut sie bei jeder Selektion neu.
Mehr lesen → -
Tableau
Sind Ihre Tableau-LOD-Ausdrücke zu komplex, um sie noch anzufassen?
FIXED, INCLUDE und EXCLUDE sind präzise Werkzeuge für echte Fragen über mehrere Granularitäten. Die meisten in Ihrem Workbook stehen dort, weil das Warehouse nie die Granularität aufgelöst oder die Historie bewahrt hat.
Mehr lesen → -
Power BI
Ist Ihr Power-BI-DirectQuery-Report bei jedem Klick langsam?
DirectQuery und Direct Lake versprechen Live-Daten. Was ankommt, ist ein Visual nach dreißig Sekunden und eine Compute-Rechnung, die niemand erklären möchte. Nicht der Modus ist das Problem, sondern das Schema darunter.
Mehr lesen → -
Qlik
Erzeugen Ihre Qlik-Apps immer wieder synthetische Schlüssel?
Synthetische Schlüssel und zirkuläre Referenzen sind Qlik, das genau das verknüpft, was es bekommen hat. Sie entstehen, weil die Daten ohne konforme Dimensionen oder echte Schlüssel ankommen, und deshalb muss jede App sie selbst erfinden.
Mehr lesen → -
Qlik
Scheitern Ihre Qlik-Reloads immer öfter, je mehr Daten es werden?
Die In-Memory-Engine ist schnell, weil alles im RAM liegt. Reloads scheitern und Apps werden langsam, wenn dieses RAM mit Details auf Zeilenebene und Transformationen gefüllt ist, die vorher kein Warehouse erledigt hat.
Mehr lesen → -
Tableau
Scheitern Ihre Tableau-Extract-Refreshes oder laufen sie ständig zu spät?
Der Backgrounder läuft in einen Timeout, die .hyper-Datei wächst weiter, und das Dashboard zeigt den Stand von gestern. Der Extract ist so groß, weil er Rohzeilen mitschleppt, die weiter oben nie aggregiert wurden.
Mehr lesen → -
Power BI
Wird Ihr Power-BI-DAX zu lang, um ihn noch zu pflegen?
Zweihundert Zeilen CALCULATE und FILTER sind kein Zeichen für fortgeschrittenes DAX. Meist sind sie ein Zeichen dafür, dass das Warehouse nie die Schlüssel, die Historie oder die Granularität geliefert hat.
Mehr lesen → -
Tableau
Wird Ihr Tableau-Dashboard bei jeder Filteränderung langsam?
Zwanzig Sekunden "Abfrage wird ausgeführt" bei jedem Filterklick. Tableau rendert nicht langsam. Es wartet auf eine Datenbank, der eine Frage gestellt wurde, die sie nicht schnell beantworten kann.
Mehr lesen → -
Power BI
Scheitert Ihr Power-BI-Refresh nachts immer wieder?
Der geplante Refresh läuft in einen Timeout, Power Query geht der Speicher aus, und Sie erfahren davon, wenn jemand das Dashboard öffnet. Die Ursache ist fast nie Power BI. Es ist das, was Power BI tun soll.
Mehr lesen → -
dbt
Der dbt Kompromiss: Code-Wildwuchs, versteckte TCO und das Argument für automatisierte Modellierung
dbt hat Software Engineering in SQL gebracht, und Teams wollen das zu Recht. Der Preis ist eine Transformationsschicht, die in Code, Kosten und Compute wächst, auf einem Ingestion-Tool, das weiterhin ein separates Produkt ist. Ein generierter Data Vault nimmt diese ganze Schicht aus der Codebasis. Er braucht dbt nicht, lässt sich aber damit kombinieren.
Mehr lesen → -
Azure Data Factory
Azure Data Factory Schwachstellen: Die versteckten Kosten von UI-Pipelines und Spark-Transformationen
Azure Data Factory ist eine solide Transportschicht innerhalb von Azure, eignet sich jedoch nicht für die Modellierung und Transformation eines Data Warehouse. Als All-in-One-Lösung führt es zu unübersichtlichen Pipeline-Diagrammen, fehleranfälligen ARM-Deployments und teuren Spark-Clustern für einfache SQL-Loads – und bindet die gesamte Logik unwiderruflich an Azure.
Mehr lesen → -
dbt
Überlässt dbt es weiterhin Ihnen, die Daten selbst zu landen?
dbt ist von seinem Design her ein Transformationstool. Es setzt voraus, dass die Rohdaten bereits im Warehouse liegen, der Landing-Schritt ist also ein zweites Produkt mit einer zweiten Rechnung, auch jetzt, wo Fivetran und dbt Labs ein Unternehmen sind. Eine Warehouse-Plattform, die an einem Ort lädt und modelliert, schließt die Lücke ohne zweiten Vertrag.
Mehr lesen → -
SSIS
SSIS-Schwachstellen: Warum das Verlagern der Packages in die Cloud nur die Altlasten mitnimmt
SSIS-Altlasten haben drei Probleme, die eine Cloud-VM nicht löst: ein Package pro Tabelle, das niemand öffnen will, Releases, die DevOps nicht erreicht, und ein Design, das bei SQL Server aufhört. Die Azure-SSIS Integration Runtime trägt alle drei unverändert in die Cloud. Ein Modell, das das Warehouse generiert, macht sie stattdessen überflüssig.
Mehr lesen → -
dbt
Treibt Ihr dbt-Run still und leise die Warehouse-Compute-Kosten hoch?
dbt führt alles im Warehouse aus, ein Full Refresh, wo ein inkrementeller Lauf reichen würde, oder eine Tabellen-Materialisierung, die jede Nacht neu gebaut wird, zeigt sich also als Credits, nicht als Fehler. Inkrementelle Logik ist in dbt optional. In einem generierten Data Vault ist sie die einzige Art, wie Loads geschrieben werden.
Mehr lesen → -
Azure Data Factory
Kosten Ihre Azure Data Factory Mapping Data-Flows mehr als die Daten, die sie bewegen?
Mapping Data-Flows laufen auf einem verwalteten Spark-Cluster, der Minuten zum Starten braucht und pro vCore-Stunde abgerechnet wird. Für eine große nächtliche Transformation ist das vernünftig. Für ein paar Hunderttausend Zeilen ist es ein Cluster, der hochgefahren wird, um zu tun, was ein einziges SQL-Statement im Warehouse tun würde.
Mehr lesen → -
dbt
Hat Ihr dbt-Projekt mehr Modelle, als irgendjemand erklären kann?
ref() macht ein neues Modell zu einer Entscheidung von einer Zeile, und ein Projekt aus Hunderten kaum kontrollierter SQL-Dateien ist das Ergebnis. Einen Business-Key weiter oben zu ändern heißt dann, jedes Modell zu finden, das ihn geerbt hat. Die Lösung lautet nicht, noch mehr Tests zu schreiben. Es ist ein Modell, das die Struktur generiert, statt sie anzuhäufen.
Mehr lesen → -
SSIS
Stößt SSIS dort an seine Grenzen, wo Ihr Cloud-Warehouse beginnt?
SSIS wurde gebaut, um Daten zwischen On-Premises SQL Server Instanzen zu bewegen. Wenn das Warehouse nach Fabric, Snowflake, Databricks oder BigQuery umzieht, sind die Optionen, die Packages auf eine Azure-SSIS Integration Runtime zu heben, Drittanbieter-Connectoren zu kaufen oder neu zu schreiben. Ein Modell, das nativ für die neue Plattform generiert, ist die vierte Option, und die einzige, die Ihre Altlasten nicht mitschleppt.
Mehr lesen → -
dbt
Wächst Ihre dbt-Rechnung in Seats oder in Engineers?
dbt Core kostet keine Lizenzgebühren, ist im laufenden Betrieb aber teuer. dbt Cloud ist einfach zu betreiben und wird pro Entwickler plus Nutzung bepreist. So oder so hat die Transformationsschicht Kosten, die mit dem Team wachsen, und keiner der beiden Wege ist der, den Sie aus diesem Grund gewählt haben.
Mehr lesen → -
Azure Data Factory
Wird jedes Azure Data Factory Release zu einem Kampf mit ARM-Templates?
Unter dem visuellen Editor ist eine Azure Data Factory JSON: Pipelines, Datasets, Linked Services und das ARM-Template, das sie deployt. Eine Änderung von Dev nach Prod zu bringen heißt Parameterdateien, globale Parameter und ein Template, das an einem einzigen Typkonflikt scheitert. Releases sollten aus einem Modell generiert werden, mit dem Rollback inklusive.
Mehr lesen → -
Fivetran
Unerwartete Fivetran-Kosten und Schema-Probleme? Wie automatisierte Modellierung die Reibungsverluste in der Ingestion beseitigt
Plug-and-Play-ELT ist schnell gestartet und schwer zu kontrollieren. Zwei Dinge erodieren mit der Zeit: was die Pipeline kostet, und wer über die Struktur der Daten entscheidet. Eine automatisierte Data Vault Schicht gibt beides zurück, ohne die Connectors aufzugeben, die funktionieren.
Mehr lesen → -
SSIS
Ist SSIS der letzte Teil Ihres Stacks, der sich CI/CD verwehrt?
Eine .dtsx Datei ist XML, das sich schlecht vergleichen und noch schlechter mergen lässt, arbeiten zwei Engineers an einem Package, endet das im Neuaufbau. Umgebungen leben in von Hand gepflegten SSISDB-Variablen-Mappings. Moderne DevOps-Praxis stößt beim SSIS-Projekt an ihre Grenzen. Releases sollten aus einem Modell generiert werden, pro Umgebung, mit dem Rollback inklusive.
Mehr lesen → -
Fivetran
Zwingt Sie Ihr Fivetran-Schema, Ihr Datenmodell nach jedem Load neu aufzubauen?
Fivetran legt jede Quelle in ihrem eigenen standardisierten Schema ab. Business-Keys, eigene Felder und Legacy-Strukturen müssen danach in SQL umgeformt werden, das bricht, sobald sich der Connector ändert. Die Lösung ist kein besseres Skript, sondern ein Modell, das die Datenstruktur vorgibt.
Mehr lesen → -
Azure Data Factory
Ist Ihr Azure Data Factory Canvas dem Team entwachsen, das ihn aufgebaut hat?
Eine Drag-and-Drop-Pipeline ist schnell zusammengeklickt, aber nur langsam anzupassen. Ab ein paar Dutzend Aktivitäten wird das Canvas zur Dokumentation, die visuelle Verdrahtung ersetzt die Fachlogik, und jede neue Quelle ist eine weitere Copy-Aktivität, die niemand anfassen will. Die Lösung ist kein aufgeräumterer Canvas. Es ist ein Modell, das die Pipelines generiert.
Mehr lesen → -
Fivetran
Explodiert Ihre Fivetran-Rechnung jedes Mal, wenn sich in einer Quelltabelle viel bewegt?
Fivetran rechnet nach Monthly Active Rows ab. Ein Bulk-Update oder eine Schemamigration im Quellsystem berührt jede Zeile erneut, und die Rechnung folgt. Die Zeilen waren nie das Problem. Teuer wird es, wenn Sie pro Zeile für Daten zahlen, die Sie anschließend ohnehin selbst noch einmal verarbeiten.
Mehr lesen → -
SSIS
Gibt es mehr SSIS-Packages als Entwickler, die sie noch durchschauen?
Hunderte .dtsx-Packages, eines pro Tabelle, jedes in Visual Studio gebaut von dem, der gerade das Ticket hatte, mit Control-Flows und Data-Flows, die sich nur einzeln öffnen lassen. Um eine Spalte zu ergänzen, müssen Sie die Packages eines nach dem anderen öffnen. Die Lösung ist kein Package-Template, sondern ein Modell, das die Loads generiert, nativ auf SQL Server, Azure SQL oder Fabric.
Mehr lesen →




Hier gibt es noch nichts.